复盘:CodeBuddy CLI 是怎么剪出一条视频的
这不是 ffmpeg 教程。这是一次人机协作的完整复盘。
素材是一条 70 分钟、11 GB 的骑行 POV,起点是一句"帮我剪一下,我要发B站", 终点是交付 5 条成片 + 一份文档。中间有 25 条用户指令、若干次拍板、两次我做错的判断。
本文重点回答三个问题: ① 提示词该怎么写? ② 哪些决定该谁做? ③ 这个 CLI 到底是怎么干活的?
一、第一条提示词:项目是怎么开始的
用户说的
"这里有我一个骑行的视频,你能帮助剪辑一下吗?我要发B站"
18 个字。没有素材规格、没有时长要求、没有风格、没有音乐。
CodeBuddy 做的第一件事
不是开始剪,是先探查环境。 并行发了三条命令:
ls -la /home/lotan/视频/DJI_001/                      # 有什么文件
which ffmpeg ffprobe && ffmpeg -version | head -2      # 工具链在不在
结果:一个 11 GB 的 DJI_20000105010609_0001_D.MP4,ffmpeg 8.0.1 可用。
然后才 ffprobe 看规格。注意顺序——先确认工具和素材存在,再花时间做深度分析。如果目录是空的或者 ffmpeg 没装,前面的分析全白做。
第二个发现:素材不止"一个视频"
初次 ffprobe 的输出被我截断了(head -100),只看到视频和音频两轨。但我在扫描文件尾部原子时发现了 djmd:
tail -c 3000000 "$F" | strings | grep -oiE "gpmd|djmd|meta|udta|gps" | sort | uniq -c于是重新完整探测,发现是五条轨道:
0 hevc video / 1 aac audio / 2 data / 3 data / 4 mjpeg video这一步直接改变了后期方案。 原计划想做"速度/里程/轨迹曲线"的数据层,但挖开遥测轨后确认:DJI Osmo Nano 机身无 GPS,遥测里只有姿态四元数。
关键动作:主动汇报"坏消息"
我没有先做能做的事,而是先把这个坏消息报给用户:
"扫描了整条遥测轨的 IEEE754 双精度值,没有任何成串的经纬度。所以速度/距离/轨迹无法从原片提取。我不会往公开视频里塞估算的速度数据。"
同时给出三条可选路径(GPX对齐 / 只做地点字幕 / 只做进度条)。
这是这个 CLI 的第一个工作特征:坏消息前置,并把决策权交回去。
二、CodeBuddy 的工作循环
整个项目跑的是同一个循环,重复了几十次:
① 探查现状   →  ② 量化分析  →  ③ 汇报结论 + 给选项
                                          ↓
⑥ 验证复核   ←   ⑤ 执行   ←   ④ 用户拍板
      ↓
   发现偏差 → 回到 ①
每一环的具体表现
① 探查现状 —— 先看,不猜
不管问什么,第一步都是读当前状态。改字幕前先读文件(因为文件被并行进程改过好几次),改时长前先算总小节数。
② 量化分析 —— 能测的都测
最基本的量化手段是抽帧:把 70 分钟每 20 秒抽一帧拼成大图,画面性质一眼可见,成本只有几分钟。
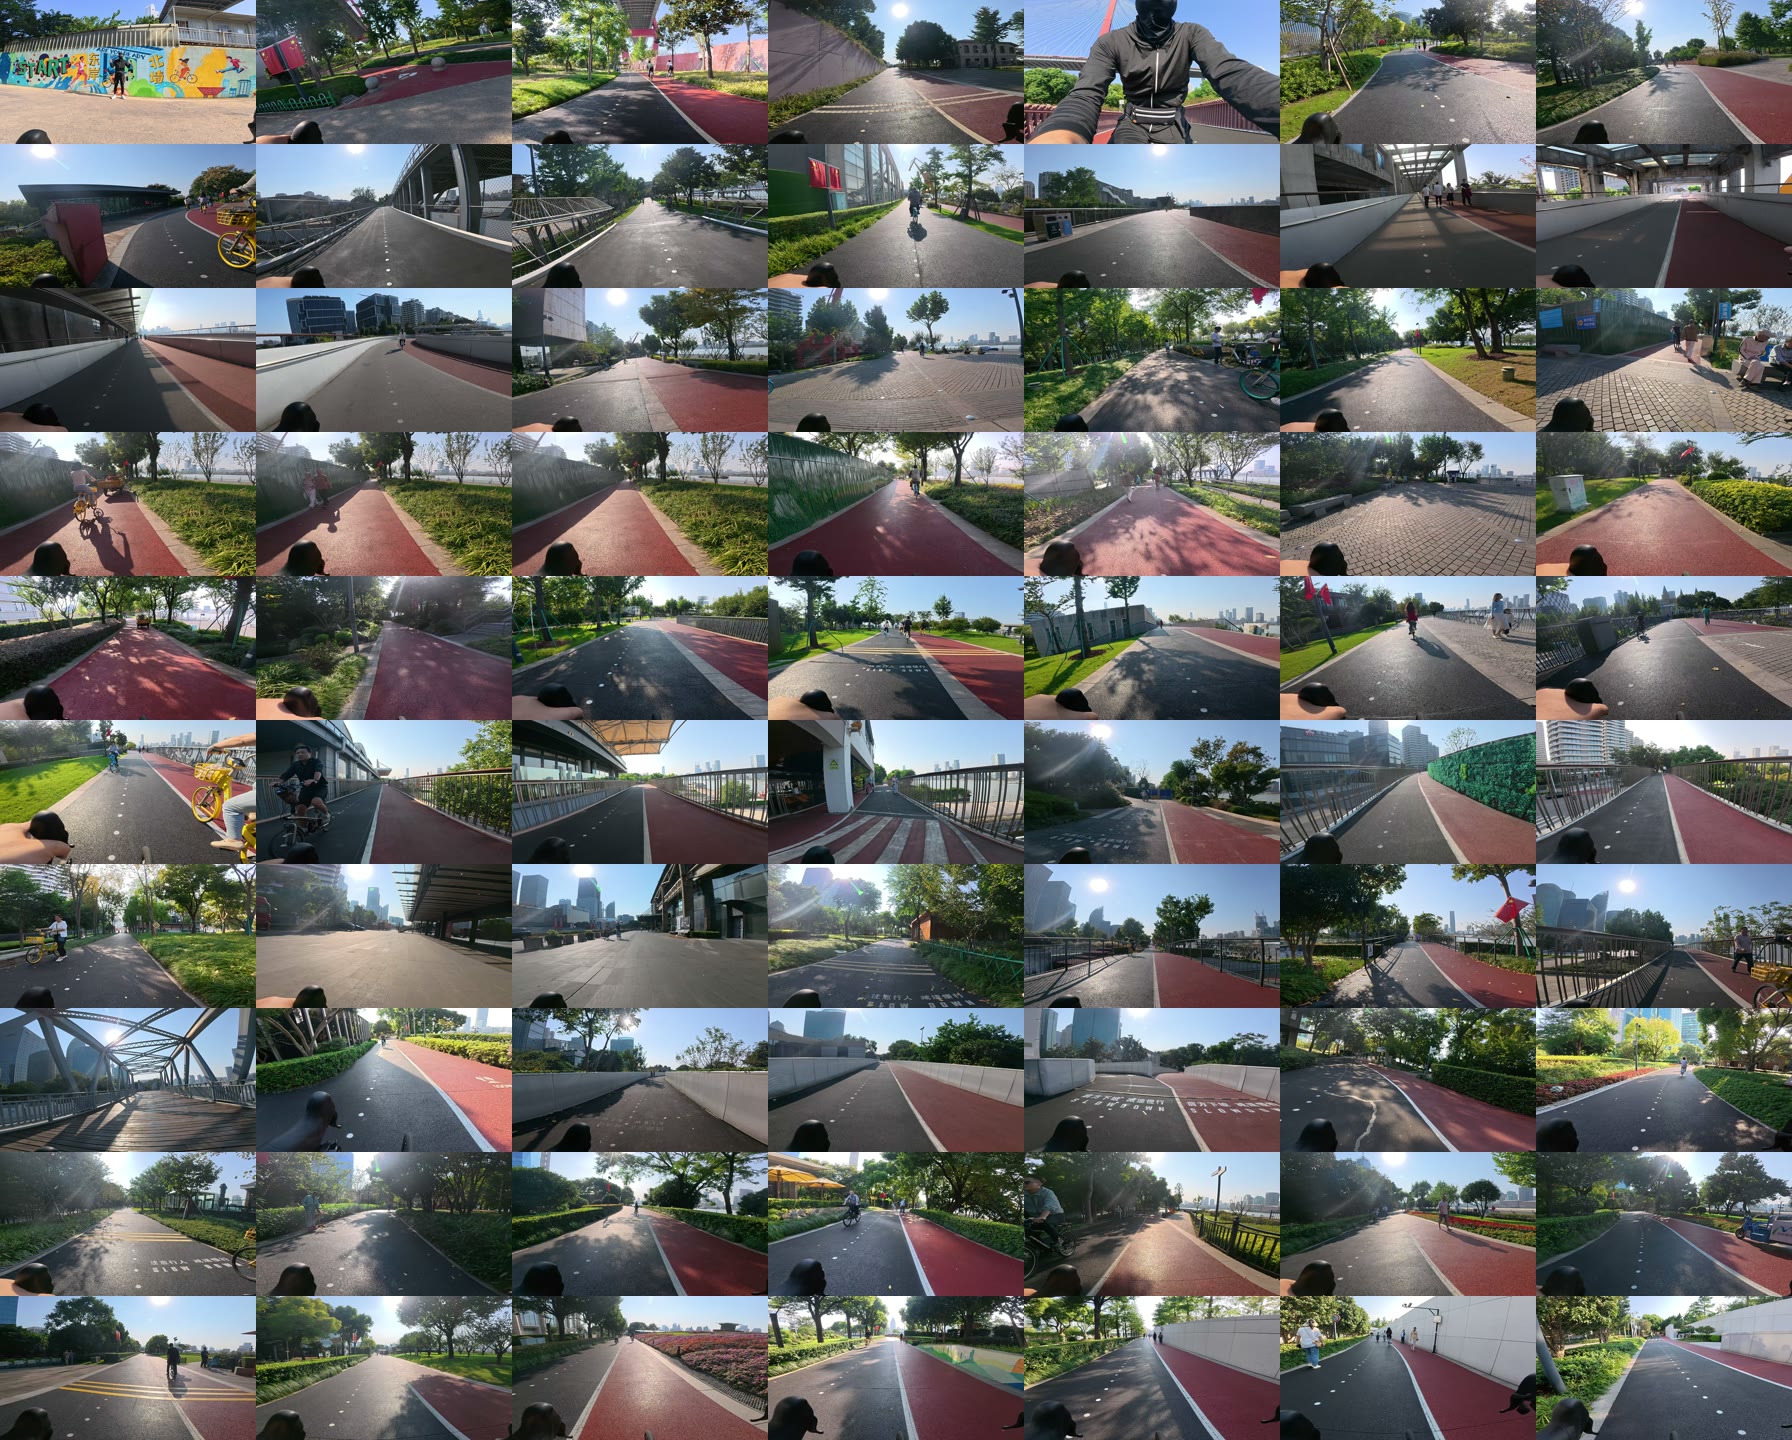
70 分钟每 20 秒一帧拼成的接触印相图。这一步不需要"看视频",只需要会读图。
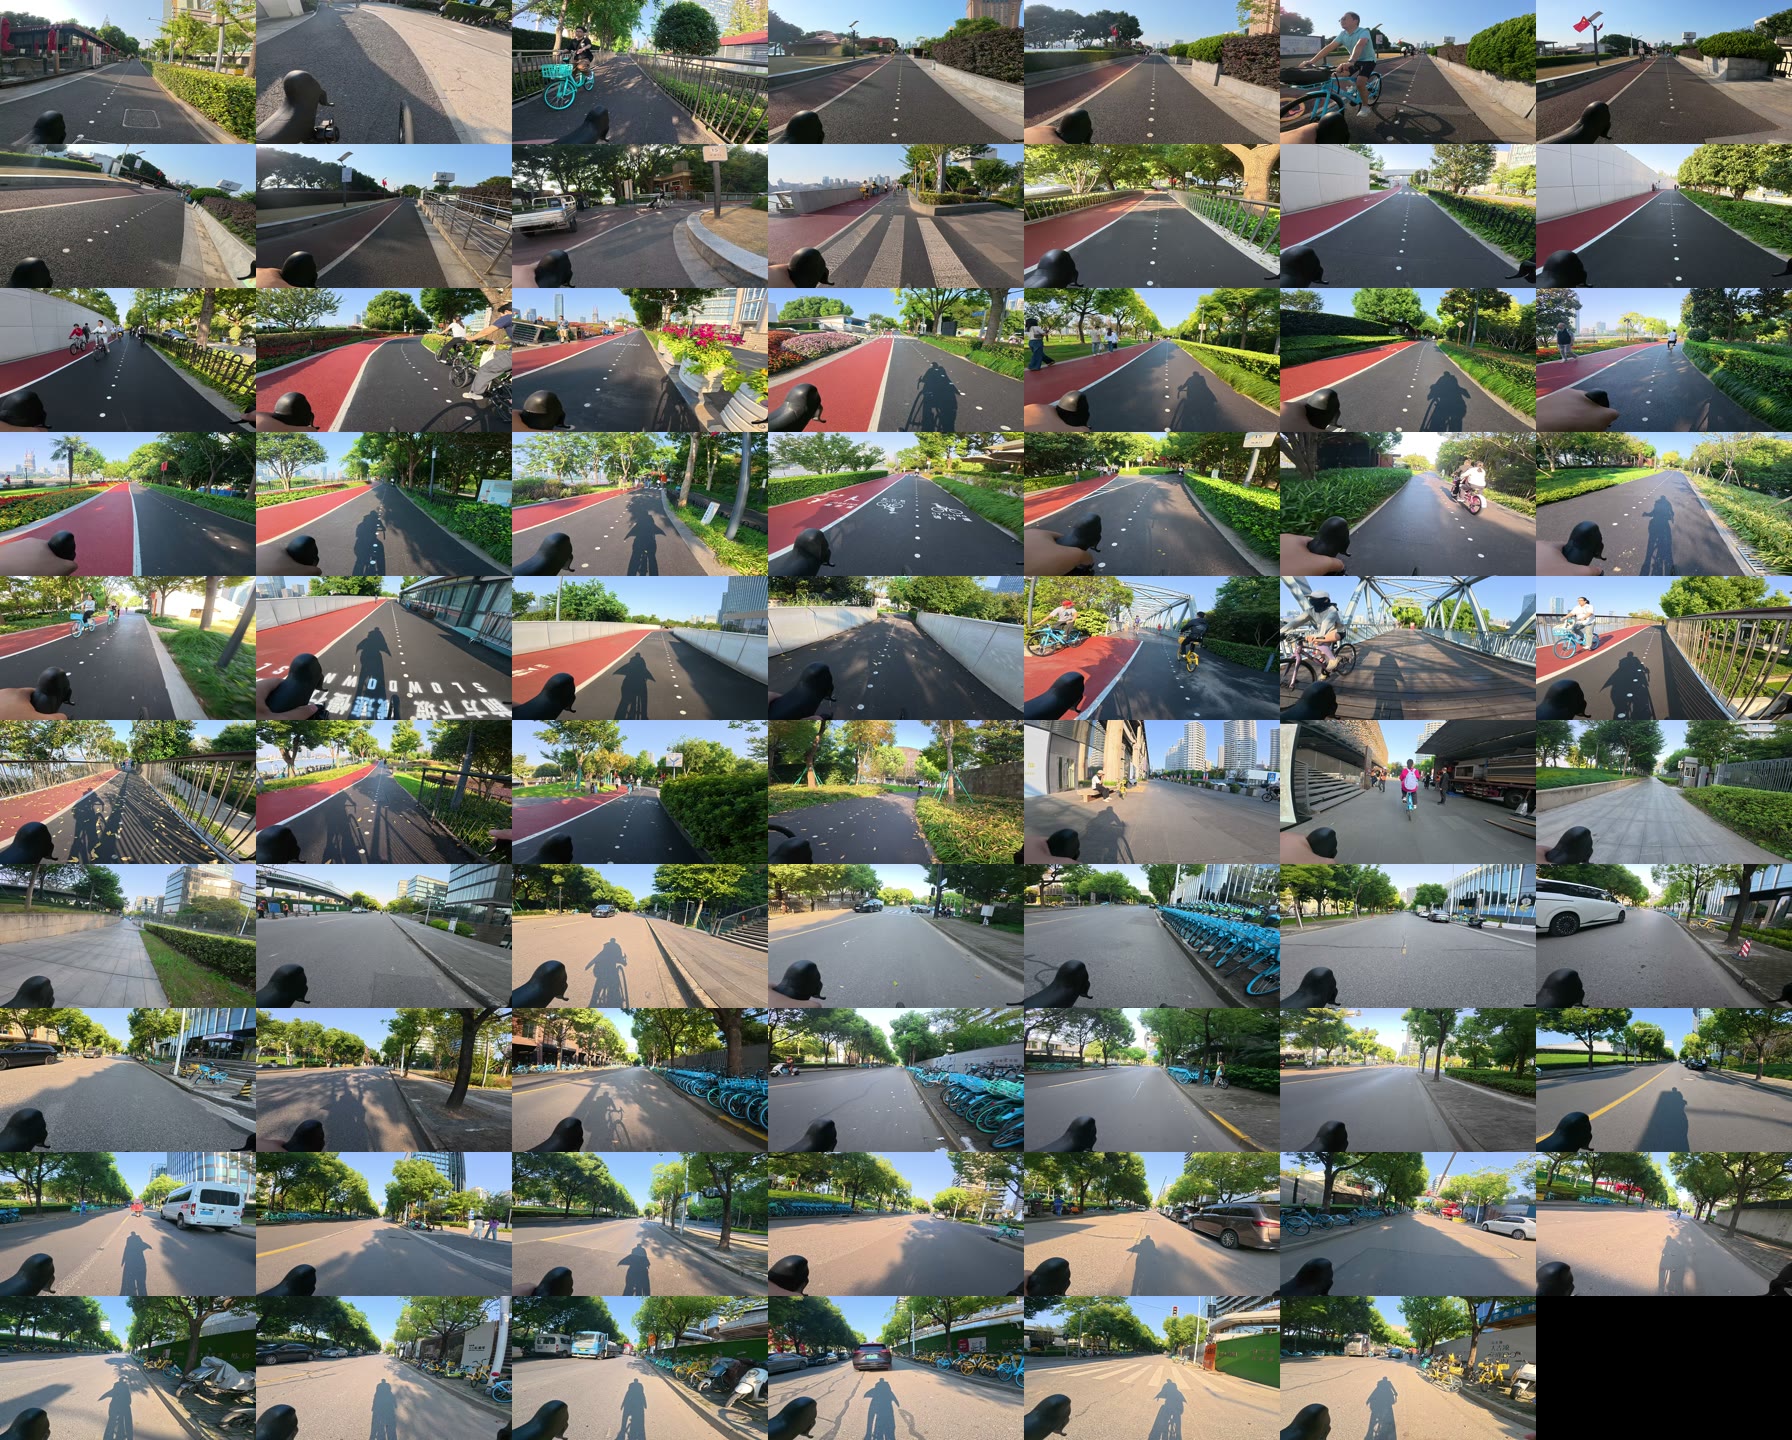
同一手法看后半段,能看出最后十五分钟从江边绿道变成了市区马路。这是"砍掉哪一半"的依据。
"这个防抖该不该加"不靠感觉,跑 vidstabtransform 看它要求放大多少:
Final zoom: 1.357495 ← 要裁掉 26% 画幅"这个调色够不够"不看图,数过曝像素:候选段选定后,再按具体时间点抽全分辨率帧确认构图:
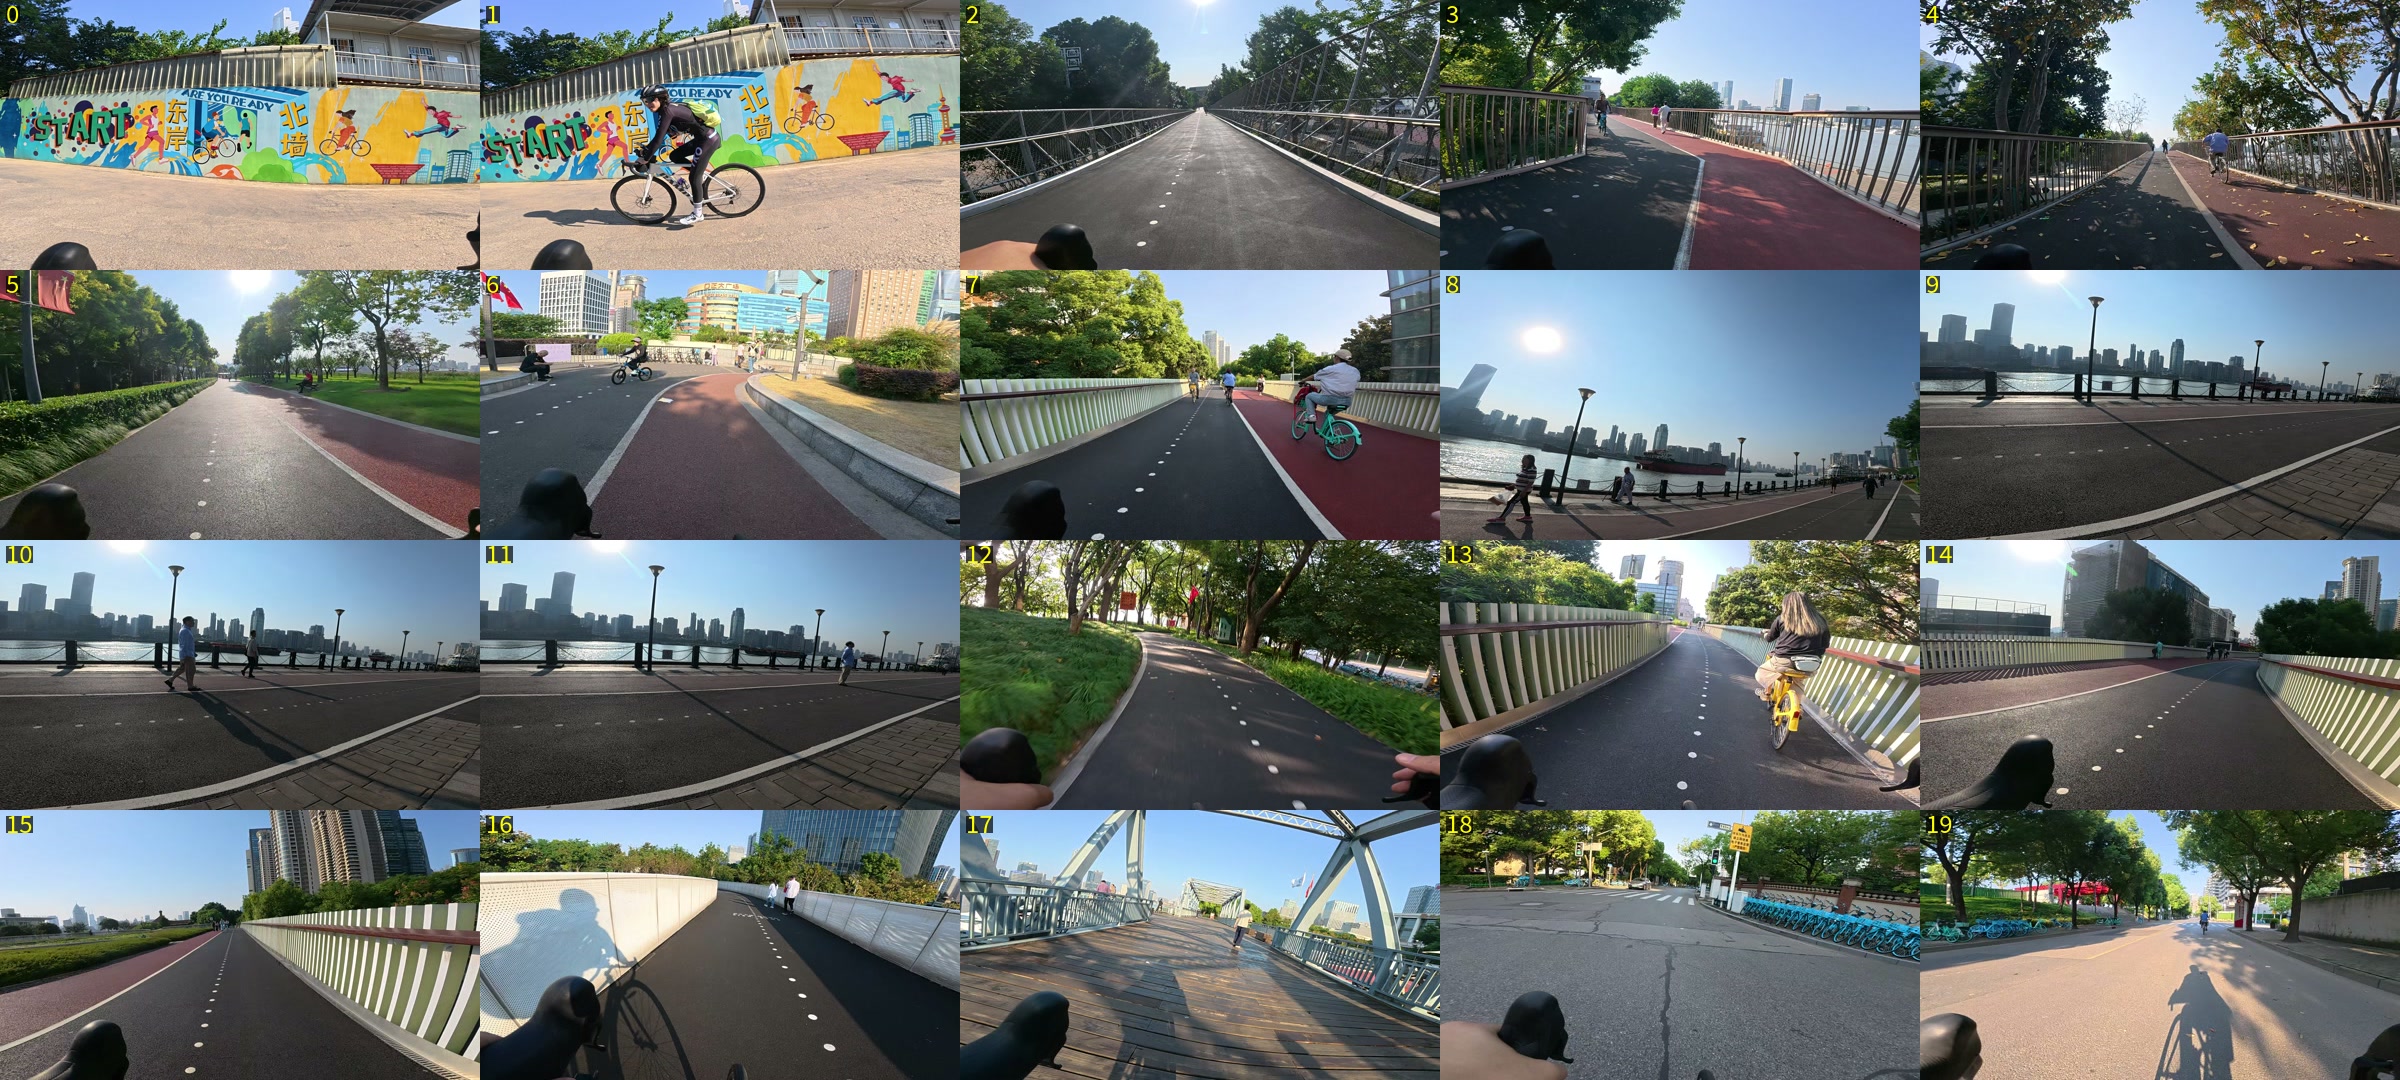
按时间点抽出的候选帧。用于最终确认"这一镜值不值得占 8 秒"。
样本2 原:过曝 0.727% 调后:过曝 1.322% ← 翻倍了,说明高光在被推③ 汇报结论 + 给选项 —— 不只报结果,还报不确定性
比如发现"音乐在 166 秒就淡出了"时,我不是直接改,而是先说明这会影响什么、有几个走法、各自代价。
⑥ 验证复核 —— 每次改动后必做
这一环是本项目代价最大的一课(见第六节)。后来固化成:每次改完画面,把所有镜头中点抽出来拼一张图过一遍。
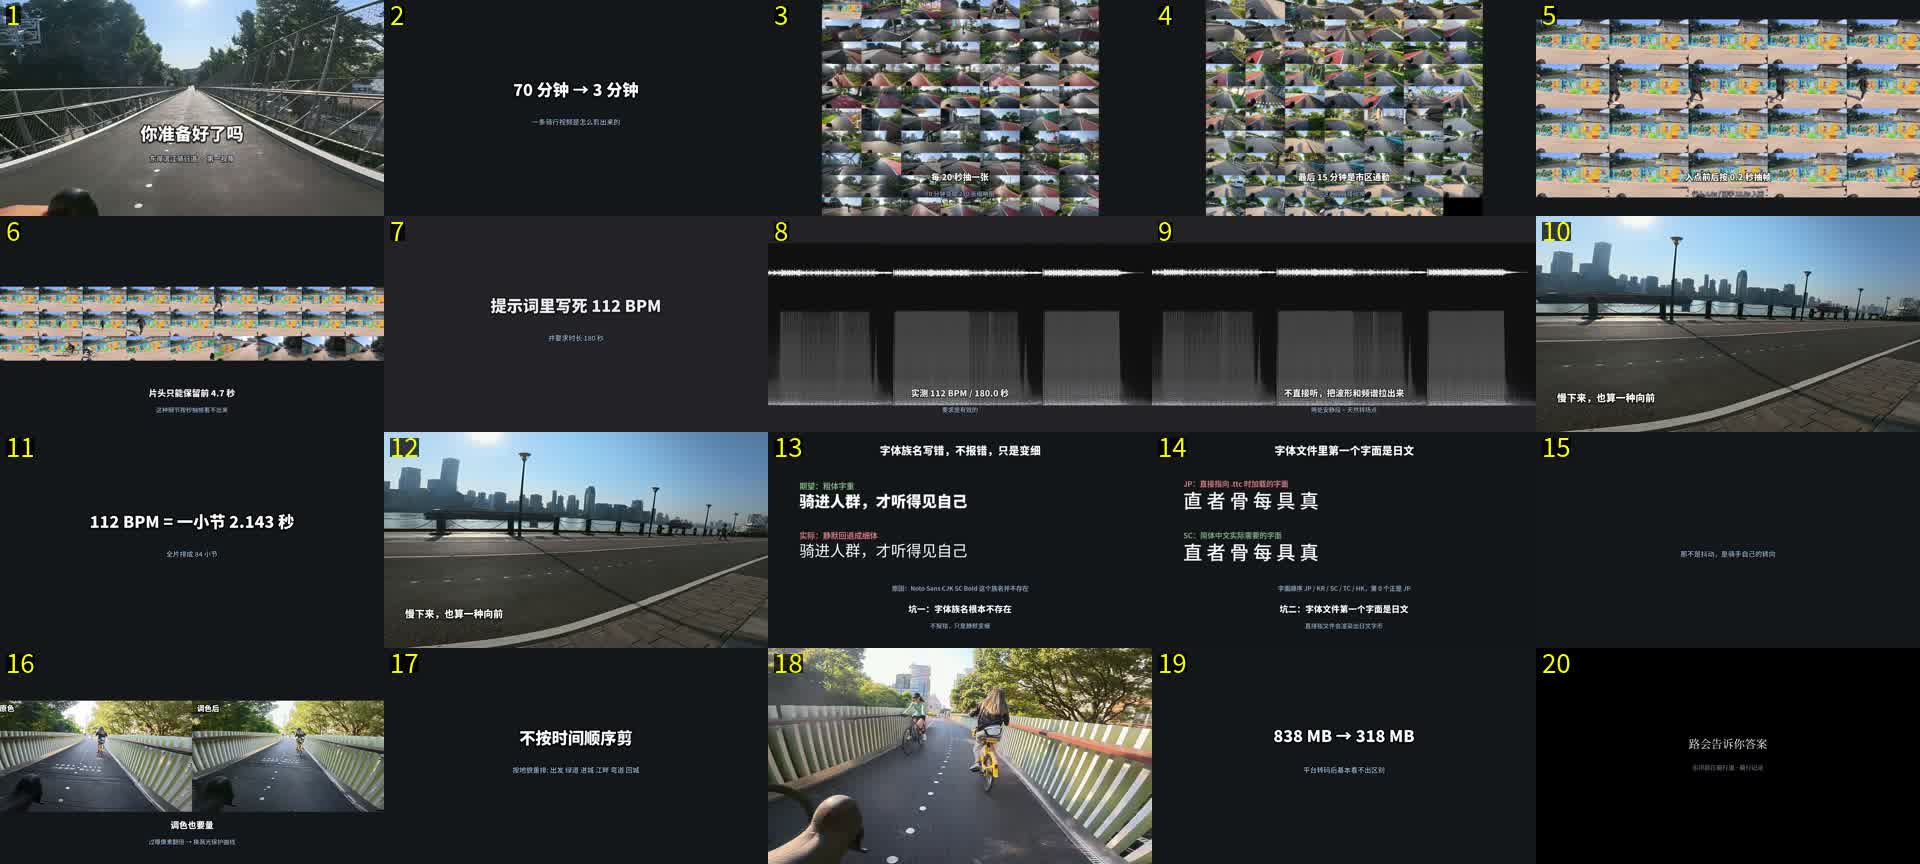
每次改完画面后的固定动作:20 个镜头各取中点拼一张,扫一眼就能发现问题。
这张图就抓到过一个不报错的问题:某张数据卡的主标题整行没渲染(文案带 % 触发 drawtext 的 Stray %,不退出、只是那行字消失)。不逐帧看就会这样交付出去。
三、25 条指令全记录
用户在这个项目里一共说了 25 句话。除第一句外,全部都是短句。
| # | 用户原话 | CodeBuddy 的响应 |
|---|---|---|
| 1 | 这里有我一个骑行的视频,你能帮助剪辑一下吗?我要发B站 | 探查环境 → 深入分析素材 → 汇报"无GPS" + 提 4 个结构化问题 |
| 2 | (回答 4 个问题)3-5分钟精华混剪 / 横屏 / 先给选曲方向 / 调色+标题+字幕+防抖 | 给出 6 个选曲方向 + 提出剪辑结构方案 |
| 3 | 用 /home/lotan/solo 中海绵音乐技能做BGM |
找到技能(目录已搬迁)→ 修 cookie 格式 → 生成 2 首 → 分析结构差异 |
| 4 | 开始的时候,镜头里出现了一个女骑手,这个画面剪切掉 | 0.2 秒精度扫描定位入画点(18.6s)→ 缩短镜头 → 重新分配小节 |
| 5 | 看完预览再定字幕文案 | 遵守,保留占位文案 |
| 6 | 文案要重构,要骑行和人生哲学风格 | 重写全套文案 + 说明"每句都咬住画面里真实存在的元素" |
| 7 | 慢下来,这句文案,要放在1分05秒,保持10秒 | 核算落点 → 确认不跨镜头 → 六帧验证正好 10 秒 |
| 8 | 上 1080p 定稿 | 调色对照测试 → 渲 1080p → 发现 910MB 码率异常 → 重出 318MB |
| 9 | 字幕的字体和背景风格优化下,参考B站主流 | 查出字体族名静默回退 → 改 Black 字重 + 描边去底衬 |
| 10 | 修下1的问题 | 定位施工围挡 67:20-67:23 → 入点后移 |
| 11 | 我的成片,声音不连续啊 | 测电平/声道 → 结论"数据正常"(判断错了) |
| 12 | 在这个里 ...mp4,第10秒开始 |
细查第 10 秒 → 音频 -18.68dBFS,再次结论"正常"(仍错) |
| 13 | 12秒后还有声音没 | 全片 1 秒精度扫描 → 0 处静音 |
| 14 | 选 BGM 并确认数据层方案 | 定 City Pop + 方案B |
| 15 | hist_m3_xuezhe 用这个 | 生成 3 版样音 → 选定声线 |
| 16 | 给我再做一个视频,来介绍AI是如果剪出这个成片的 | 4 个结构化问题定方向 → 写 45 句解说 → 10 场景构建 |
| 17 | 等 TTS 完成后构建画面 | 等待 → 构建 → 修 4 个错误 |
| 18 | 出封面候选 | 4 个方向大字报封面 |
| 19 | 给我这个视频写1000字的简介 | 1063 字符简介 + 标签 |
| 20 | 把两条组合在一起,讲完原理,给大家放一下成片 | 加过渡卡 → -c copy 拼接 → 314s |
| 21 | 用 c2_印相图.png 这个图,写一个爆款标题 |
主推标题 + 8 个备选 + 明确"不建议的写法" |
| 22 | 给我这个视频写的 | 定稿标题 + 写入 MP4 元数据 |
| 23 | 给我这个视频写1000字的简介 | (重写) |
| 24 | 给我写一个md,主题是上面的视频工作,教学类 | 写了技术教程版 |
| 25 | 这个md没有codebuddy的提示词和人类选择判断的过程 | 重写为本文 |
这张表读出来的三件事
第一,用户的指令极短。 25 句里最长的是第 1 句(18 字)。这不是用户偷懒,而是正常的协作方式——方向和取舍由人给,实现细节不该由人管。
第二,"修一下""改一下"这类模糊指令,靠的是上下文。 第 10 句"修下1的问题"只有 6 个字,指的是上一轮我列出的两个问题里的第一个。CLI 必须能接住这种指代。
第三,第 11-13 句是连续三次同一个问题。 这是全项目最值得复盘的一段——用户说了三次,我判错了三次。
四、决策分工:哪些事该谁拍板
这是整篇最核心的一张表。
| 决策点 | 谁拍的 | 怎么拍的 |
|---|---|---|
| 成片形式(混剪/短视频/加速) | 用户 | AskUserQuestion 四选一 |
| 画幅(横屏/竖屏) | 用户 | 同上 |
| 数据层方案(GPS缺失怎么办) | 用户 | 三选一,AI 给推荐 |
| 音乐风格 | 用户 | AI 给 6 个方向,用户选 |
| 解说音色 | 用户 | AI 生成 3 版样音,用户听后定 |
| 文案风格(哲思) | 用户 | 用户一句"要骑行和人生哲学风格" |
| 某句文案的位置与时长 | 用户 | "放在1分05秒,保持10秒" |
| 视频要不要缩短 | 用户 | AI 给 4 个走法,用户选 |
| 哪些段落可用 | AI | 抽帧分析后汇报 |
| 切点定在哪一秒 | AI | 拍网格 + 逐帧扫描 |
| 防抖加不加 | AI 建议,用户默认接受 | 算法实测后建议否决 |
| 调色曲线选哪条 | AI | 过曝像素量化对比 |
| 码率怎么控 | AI | 完整滤镜链压力测试 |
| 字体用什么 | AI | fc-match 逐个验证 |
| 标题怎么写 | AI 提案,用户定稿 | 用户中途给了自己的方向 |
| 哪些坑要写进文档 | AI | 按危险程度排序 |
分工的规律
涉及"想要什么"的,归用户。 形式、风格、画幅、时长、文案调性——这些没有客观答案,AI 不该替用户决定。
涉及"怎么实现"和"客观事实"的,归 AI。 哪一秒是入点、要不要加防抖、码率压到多少——这些有唯一正确答案,可以量化,AI 应该直接给结论。
中间地带用"AI 提案 + 用户确认"。 比如标题:我给主推 + 8 个备选 + 明确说明哪些写法不建议。
AskUserQuestion 什么时候用
本项目用了两次结构化提问:
- 第一次:项目开始时,一次性问 4 个问题(形式/画幅/音乐/附加处理)
- 第二次:做教程片前,一次性问 4 个问题(定位/时长/旁白/画面形式)
共同点:在动手之前,把会影响整体架构的问题一次性问清。
反面例子:我在"成片时长"这一点上问晚了。等音乐生成完才发现 180 秒的音乐配不上 3-5 分钟的目标,只能回头讨论缩短方案。如果一开始就问"成片目标时长",这段返工可以避免。
五、AI 主动否决用户的三个案例
用户勾选或提出的东西,AI 不一定照做。本项目否决了三次。
案例一:防抖(用户勾选了,AI 建议否决)
用户在第一次提问里明确勾选了「画面防抖」。
我没有直接加,而是先测:
ffmpeg -ss 2600 -t 60 -i input.MP4 \
  -vf "vidstabdetect=shakiness=6:accuracy=15:result=/tmp/trf.trf" -f null -
ffmpeg -ss 2600 -t 3 -i input.MP4 \
  -vf "vidstabtransform=input=/tmp/trf.trf:debug=1" -f null - 2>&1 | tail -5
输出 Final zoom: 1.357495——要求放大 35.7%,即裁掉 26% 画幅。同时检测日志大量 disabled ... residual: 62.8,说明运动估计本身不可靠。
结论:这不是抖动,是骑手主动的前进和转向。 我建议不做,并说明了代价(裁 1/4 画面换一堆果冻扭曲)。
用户接受了。
案例二:数据层(拒绝编造数字)
用户选了"数据层方案 B"(只做地点+章节字幕)。但更值得注意的是我没有提供的那个选项。
素材无 GPS,速度/里程/轨迹全部不可得。技术上我完全可以用画面运动估算速度、按地图估算里程——但那会往公开视频里塞假数据。
我的处理方式:把"用画面估算速度"作为一个选项列出来,但明确标注不推荐,理由写在选项说明里。最终用户选了不涉及数字的方案。
案例三:标题写法
用户让我用某张封面写"爆款标题"。
我除了给主推和 8 个备选,还单独列了一节"不建议的写法":
| 类型 | 例子 | 为什么不用 |
|---|---|---|
| 空洞形容词 | 震惊、绝了、太强了 | B站 观众已免疫,反而降低点击 |
| 与实际不符的定位 | 零基础、保姆级 | 吸引的观众预期不符,完播率掉 |
| 不准确的技术描述 | "AI 一键剪片" | 实际每步都有量化检查,会引来"这也叫 AI"的评论 |
这比多给几个标题更有用——用户真正需要的不是更多选项,是判断标准。
六、用户纠偏与 AI 的响应
纠偏一:女骑手(一次就准)
用户:"开始的时候,镜头里出现了一个女骑手,这个画面剪切掉"
第一轮扫描我只做到 1 秒精度,看到"第 19 秒有人"。但 1 秒精度取不到边界值,所以我把精度提到 0.2 秒:
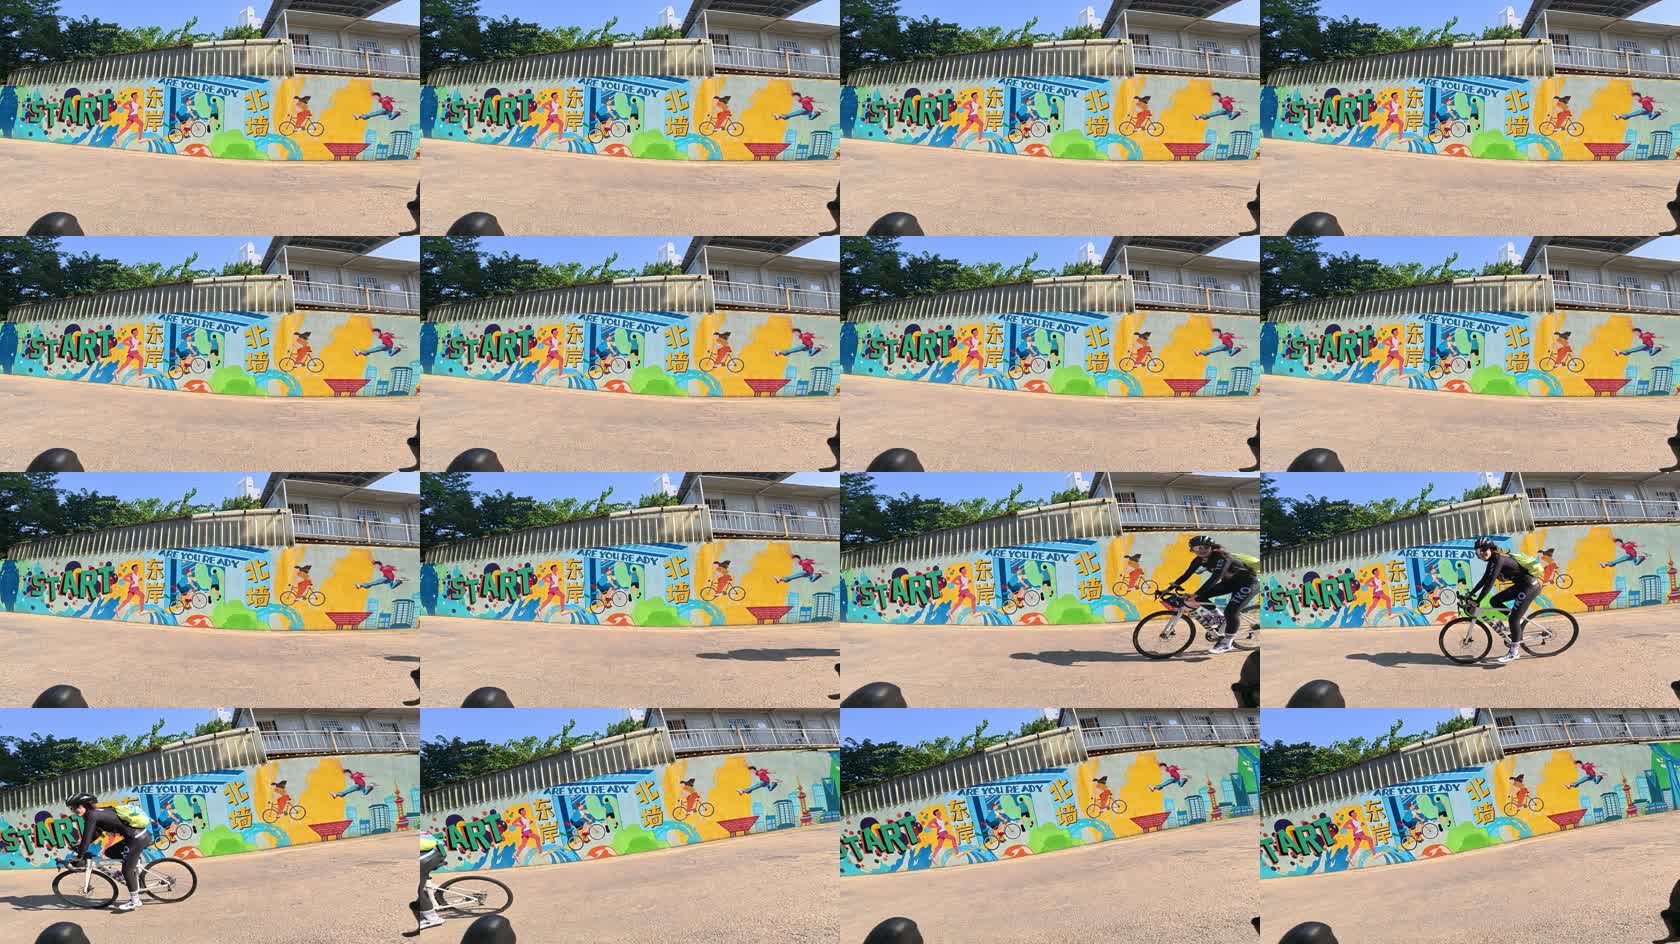
0.2 秒精度扫描:18.0 秒画面干净,18.2 秒影子进来,18.6 秒车身入画。
同一手法扫另一段,能看到行人入画的边界:
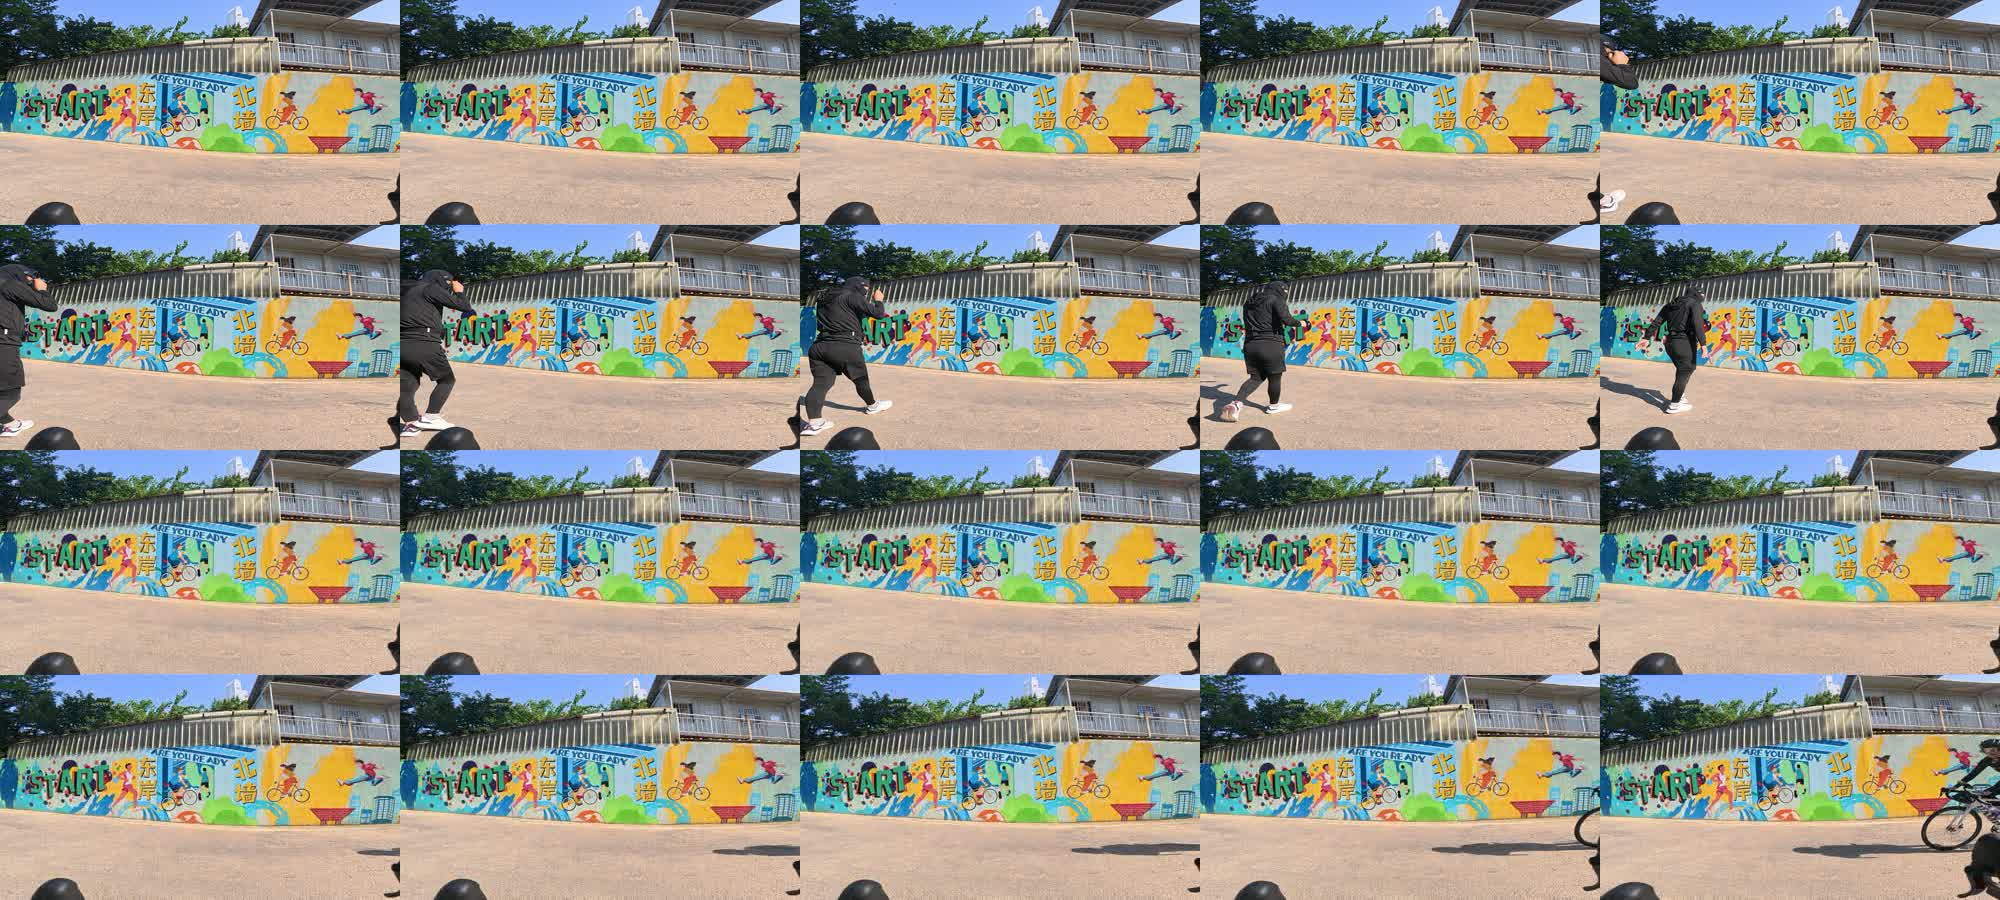
上下两行分别是两个区间的 0.2 秒扫描。边界值一目了然。
最初的 1 秒精度扫描只能给出"第 19 秒有人"这种粗结论:
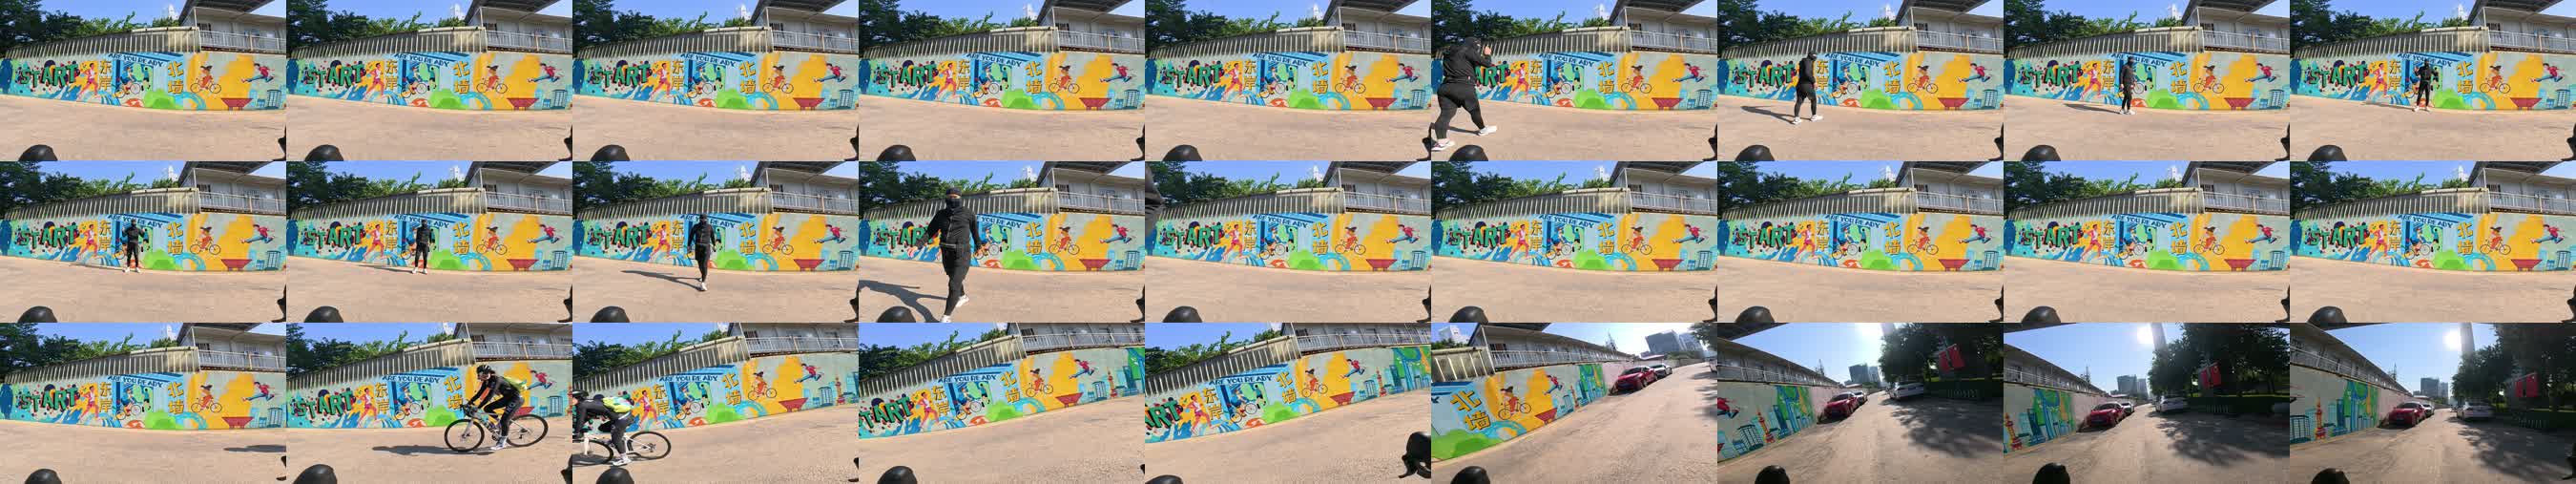
1 秒精度扫描。能看到第 12-21 秒有骑行者经过,但取不到精确边界。
最终确定:真正无人的窗口只有 0 到 4.7 秒,片头只能取 4.7 秒。同时我主动补报了一个用户没提的问题——第 4.8 秒还有行人入画,所以片头取到 4.286 秒(2 小节)留了余量。
纠偏二:声音不连续(三次判错,这段最值得看)
用户连续说了三句:
"我的成片,声音不连续啊" "在这个里
...mp4,第10秒开始" "12秒后还有声音没"
我做了四轮检查,四轮全部判定"正常":
| 我的检查方法 | 结果 |
|---|---|
ffprobe 看流时长 |
视频 140.840s / 音频 140.840s → 正常 |
ffmpeg -f null - 看自报时长 |
time=00:02:20.84 → 正常 |
silencedetect 扫全片静音 |
0 处 → 正常 |
| 解码后测电平/RMS/语音频段能量 | 全部连续 → 正常 |
四轮全过,问题真实存在。
转折点是我去查音频包的采样时长:
第 662 包   pts 11.096250   duration 5.729417   size 822 字节
第2917 包   pts 61.905938   duration 5.529396   size 859 字节
包体只有 822 字节(约 21 毫秒的 AAC),时长却被写成 5.7 秒。播放器按时间戳推进,走到 11.1 秒和 61.9 秒没有内容可播——这就是"断断续续"。
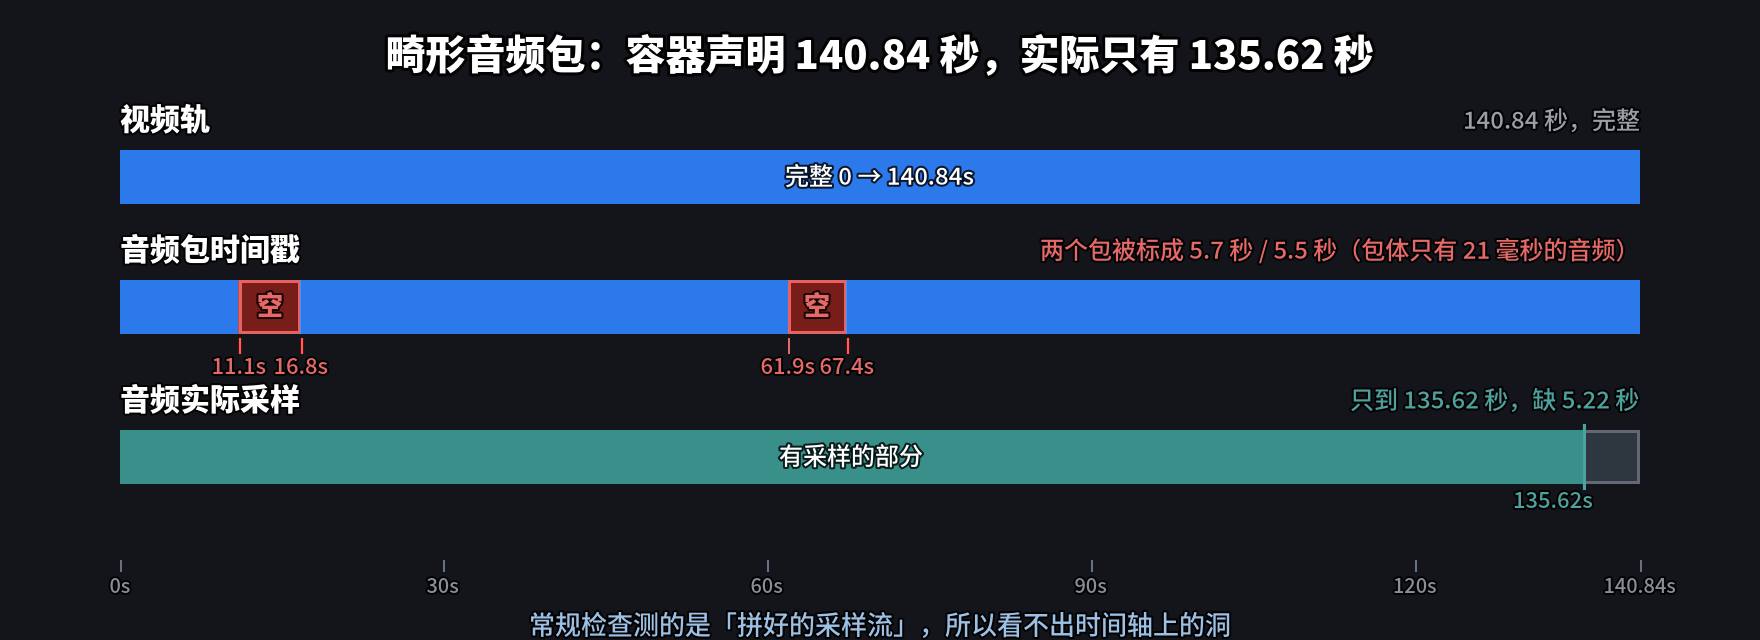
三条时间轴并排:视频完整;音频包的时间戳有两个洞;音频实际采样只到 135.62 秒。
用户说的"第 10 秒开始"完全准确,那个洞就在 11.1 秒。
为什么四轮都测不出来
ffprobe报的流时长是对的(容器声明 140.840 秒)ffmpeg -f null -报的time=是最后一帧的时间戳,不是采样数- 解码后首尾相接测电平也完全正常——因为采样数据是连续的,只有时间戳有洞
我用的方法从原理上就有盲区:它们的输入都是"已经拼好的采样流",测不出时间轴上的洞。
正确方法是完整解码音频数采样数,和视频长度比对:
def decoded_seconds(path, stream):
    if stream == "a":
        p = subprocess.run(["ffmpeg","-v","error","-i",path,"-map","0:a",
                            "-f","s16le","-ac","1","-ar","48000","-"],
                           capture_output=True)
        return len(p.stdout) / 2 / 48000
    # 视频解不了 s16le,按帧数换算
    j = ffprobe_json(path, "nb_read_frames,r_frame_rate")
return int(j["nb_read_frames"]) / eval_fps(j["r_frame_rate"])跑出来:视频 140.840s / 音频 135.616s / 差 -5.224s,问题立刻暴露。
根因与修法
不要把视频滤镜和音频滤镜放进同一个 filter_complex。 视频分支的 fade 和音频分支的 apad+loudnorm 同图时,ffmpeg 在 flush 阶段丢音频帧。换成 -map 0:v(视频不经滤镜)就正常。
修法:拆成三步——视频轨、音频轨分别渲染,再用 -c copy 合并。
这段复盘的三条教训
- 用户说"有问题"时,先怀疑自己的检测方法,而不是先怀疑用户。 我前三轮都得出"正常",语气越来越自信,实际上是在用错误的尺子反复量。
- 一个信号出现两次以上,就不能再当噪声。 我早先两次看到"音频只有 135/138 秒",都当成读取管道的截断假象排除了——那两次就是本该抓住它的机会。
- 验收标准要能覆盖"数据对但时间轴错"这类问题。 现在两个构建脚本都会自动解码数采样比对,差超 0.3 秒直接报错退出。
纠偏三:文案要重构
用户:"文案要重构,要骑行和人生哲学风格"
我重写了全套文案,但做了两件用户没要求的事:
一是每句都锚定画面里真实存在的元素。 不是写漂亮的鸡汤,而是让字和画面咬合:
| 文案 | 画面里对应什么 |
|---|---|
| 你准备好了吗 | 涂鸦墙上真实的 "ARE YOU READY" |
| 慢下来,也算一种向前 | 江畔本来就是慢速滑行 |
| 影子跟着你,路得自己骑 | 骑行者自己的影子投在路面上 |
| 拐弯不是绕路,路本来就这样 | 连续 S 弯 |
二是明确说明避开了什么。 我告诉用户刻意没写"人生就像骑行"这类直白比喻——留给观众自己连线,比说出来高级。
纠偏四:这份文档本身
用户:"这个md没有codebuddy的提示词和人类选择判断的过程,md重点要复盘这个codebuddy cli是怎么干活的"
我把复盘的对象搞错了。 我写成了 ffmpeg 技术教程,但用户要的是"这个工具是怎么干活的"。
这属于对需求的理解偏差,不是执行错误。触发点是用户看清了产出物才发现。教训是:写文档前应该先确认"复盘的对象是技术还是协作"。
(本文即为重写版。)
七、量化验证:CLI 剪片和手剪的根本差别
用命令行剪片的核心不是"用命令代替鼠标",而是把每一个判断变成可测量的数字。
| 判断 | 手剪怎么做 | CLI 怎么做 |
|---|---|---|
| 这段能不能用 | 拖时间轴看 | 抽帧拼图 + 具体入画时间 |
| 切点对不对 | 听感觉 | 小节线上算时间戳 |
| 调色够不够 | 看屏幕 | 数过曝像素百分比 |
| 防抖要不要加 | 试了看 | 算法要求的裁切比例 |
| 码率合不合适 | 导出看体积 | 完整滤镜链压力测试 |
| 音频连不连续 | 听 | 解码采样数对比 |
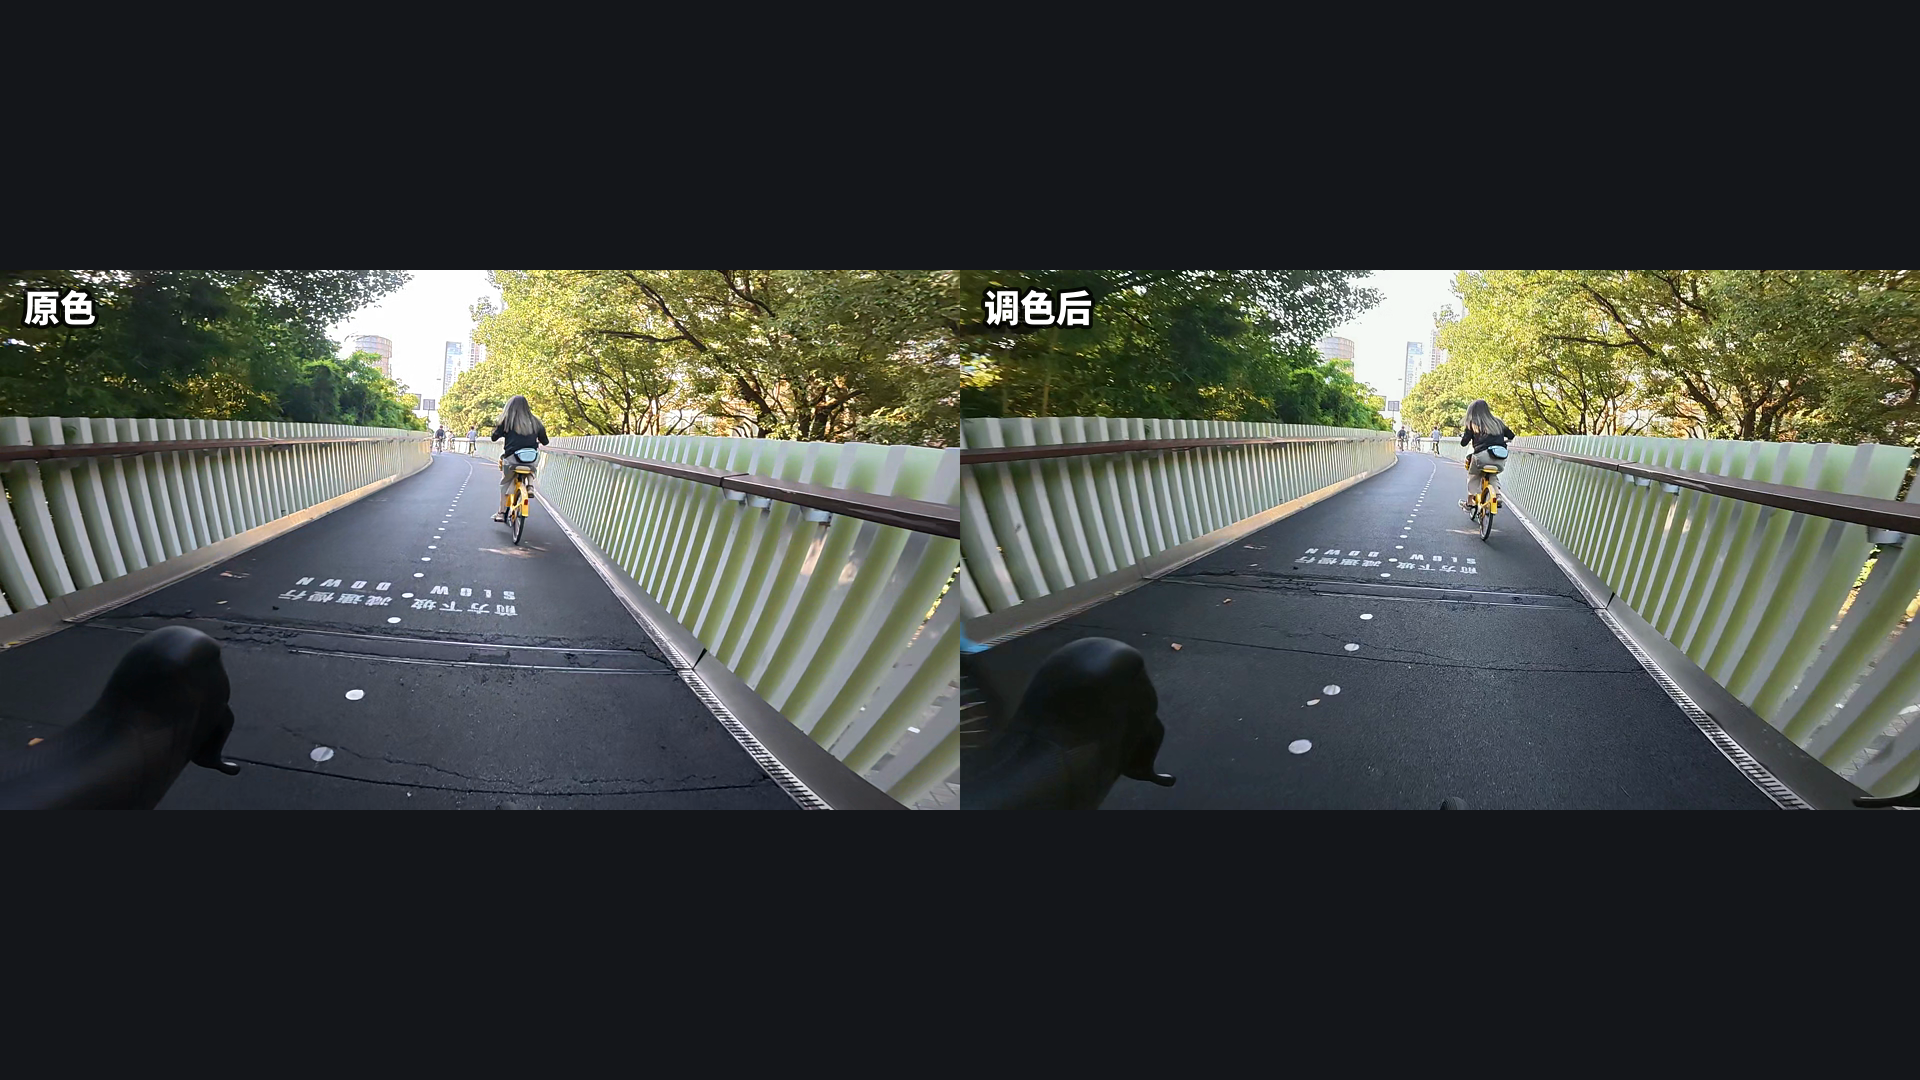
调色的判断依据不是"看着好看",是过曝像素从 0.398% 涨到 0.730% 这个数字。
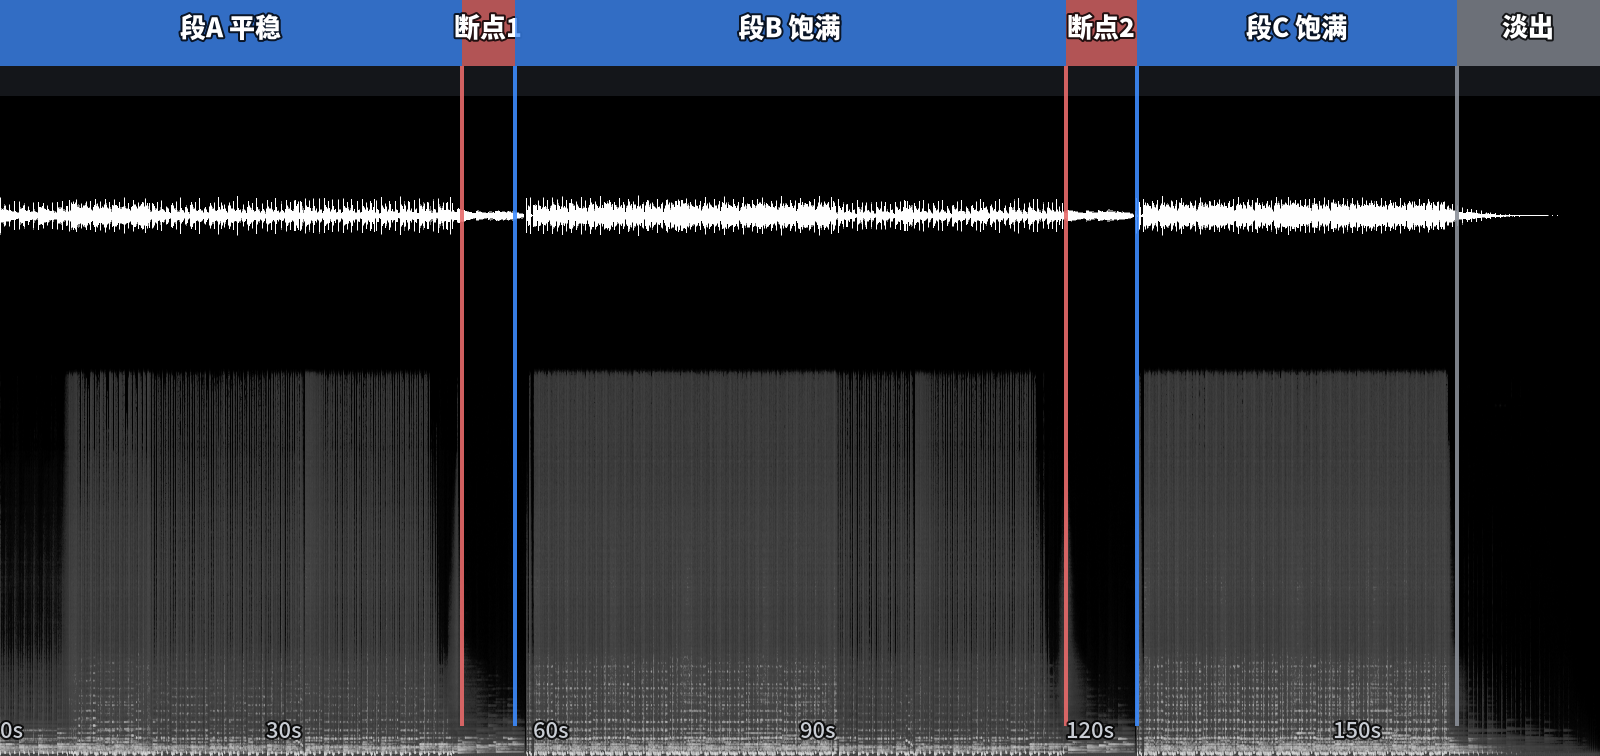
音乐的段落边界不是听出来的,是从波形和 RMS 曲线读出来的,精确到秒。
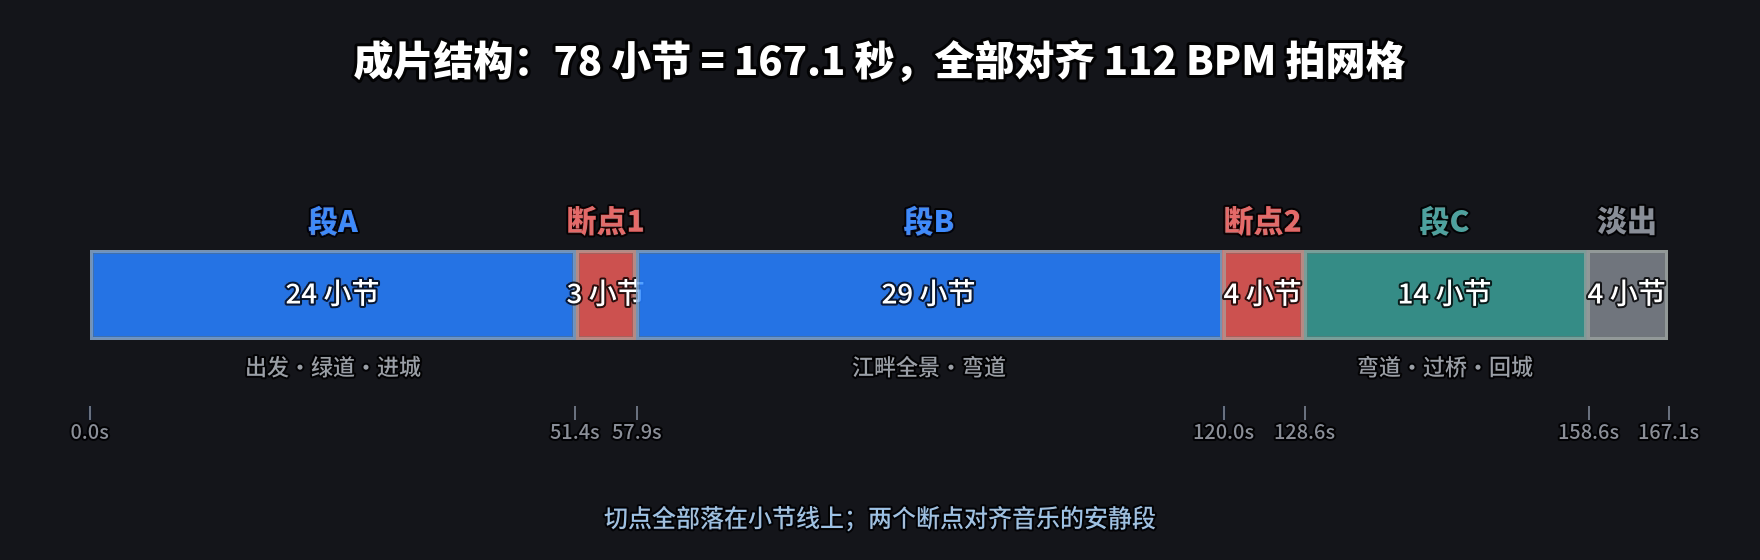
成片结构同样是算出来的:78 小节、每段小节数、每段起止时间,全部落在小节线上。
这套方法的价值在哪
可复现。 三个月后想改一个字幕,改一行参数重跑就行,不用重新做一遍手感判断。
可交接。 所有决策都有数字支撑,别人接手时能看懂"为什么这里是 4.7 秒"。
能发现静默失败。 本项目踩到 7 个"不报错、只是结果错"的坑(见下)。这些坑靠看日志一个都发现不了,只能靠量化检查。
靠量化抓到的静默失败
本项目踩到 7 个"不报错、只是结果错"的坑。挑两个有代表性的:
字体族名不存在,静默回退成细体。 font='Noto Sans CJK SC Bold' 这个族名根本不存在,
fontconfig 会一声不吭地回退到 Regular,ffmpeg 不报错,只是字一直是细的。
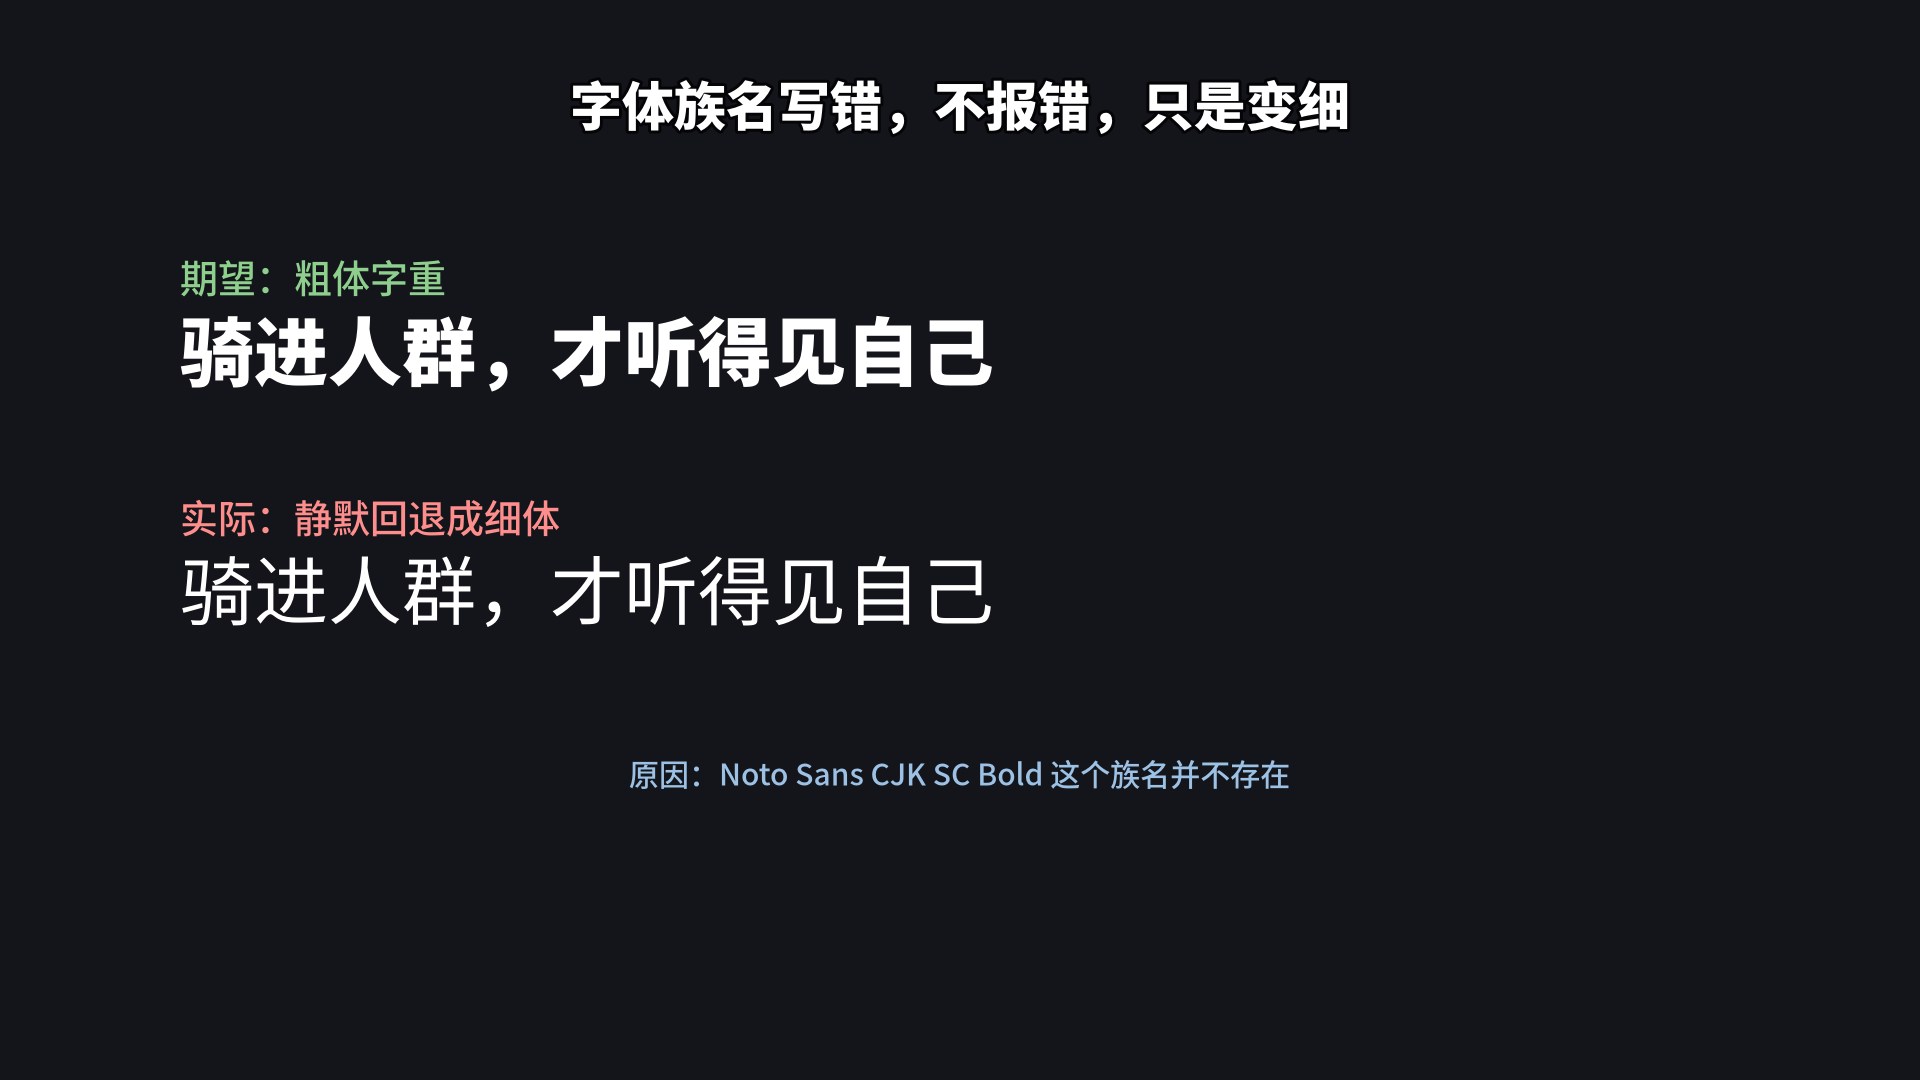
同一个族名的两种写法。这个差异不会让 ffmpeg 报任何错,只能靠抽帧看出来。
.ttc 集合字体的第 0 个字面是日文。 NotoSansCJK-*.ttc 的字面顺序是 JP/KR/SC/TC/HK,
用 fontfile= 直接指过去,渲染出来是日文字形。
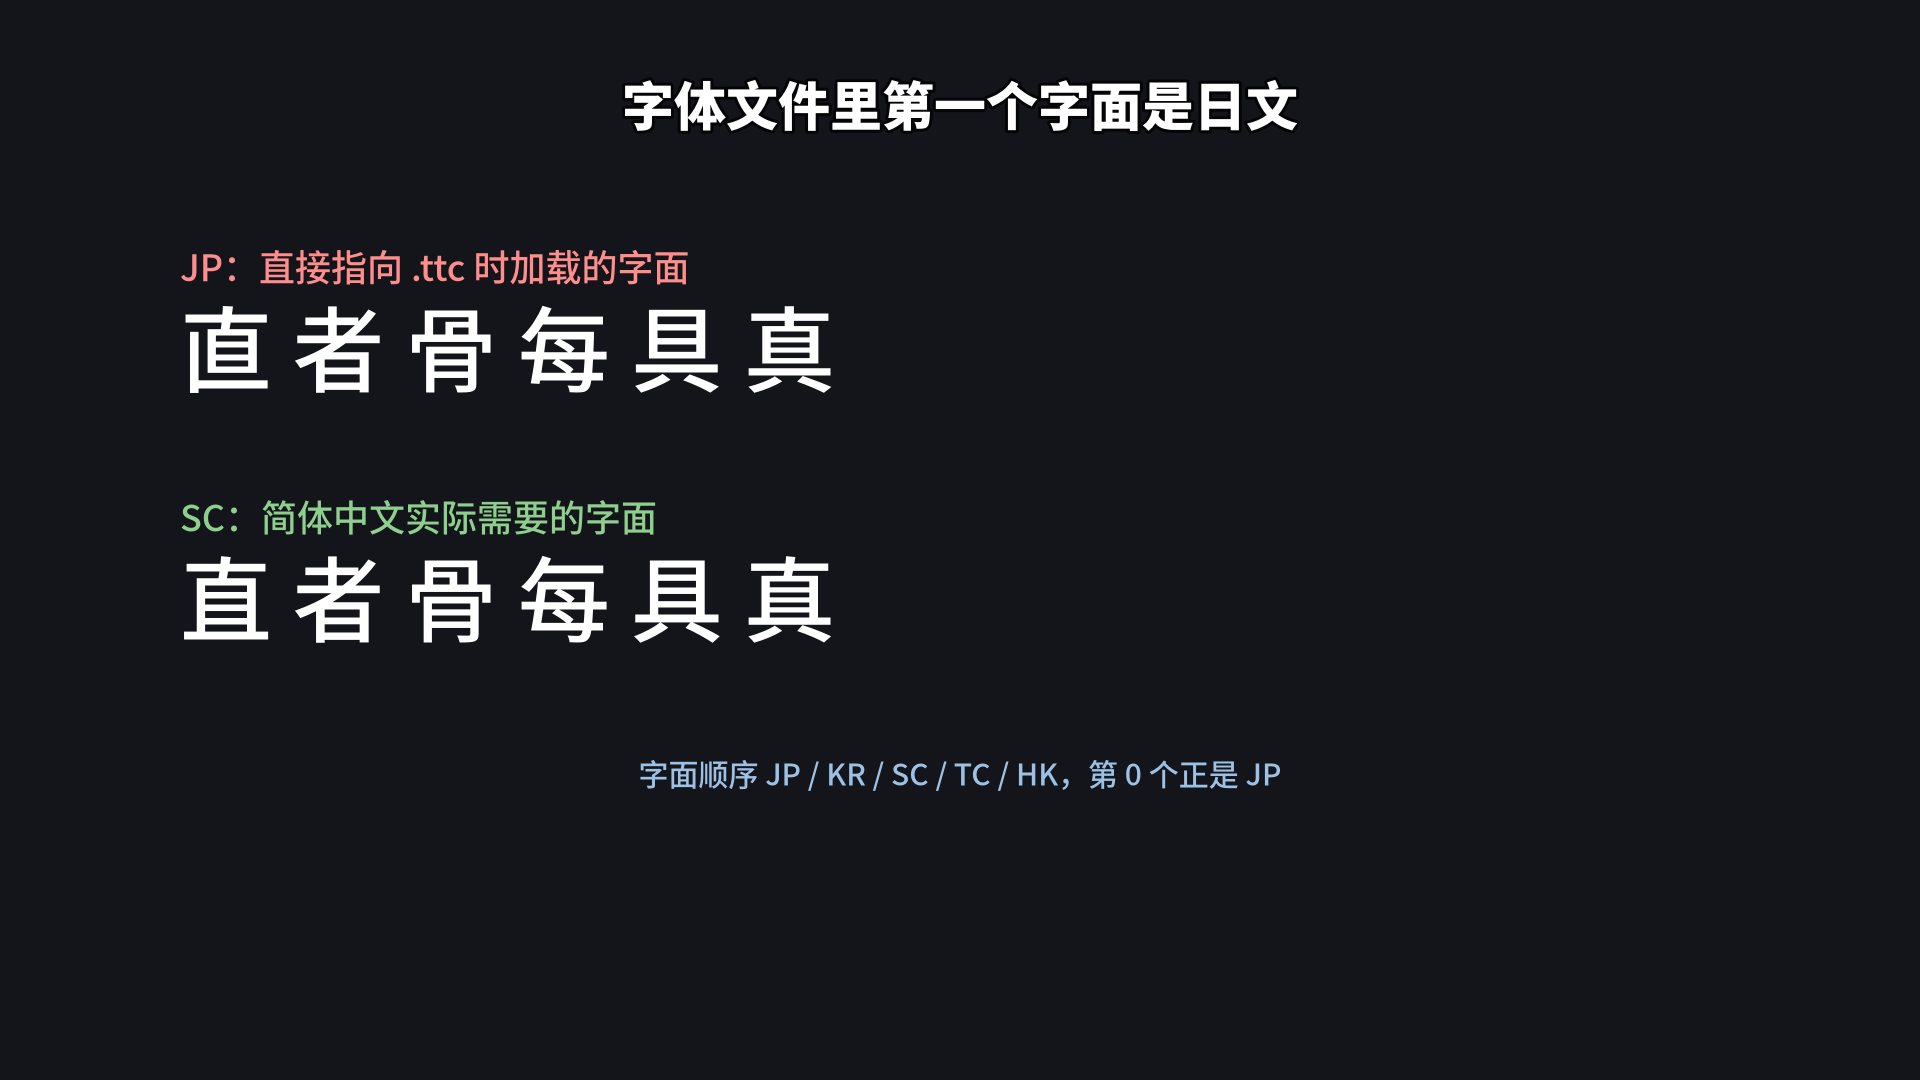
同一字重下,日文字面与简体字面的差异。在「者」「直」上最明显,肉眼容易漏。
八、复盘:值得保留的与要改的
值得保留的四个做法
一、动手前先探查环境。 本项目第一次探查就发现"素材有五条轨道"和"没有 GPS",直接改变了后期方案。如果上来就剪,后面要返工。
二、坏消息前置。 发现无 GPS 时,我没有先做能做的部分,而是立刻把限制和选项交回用户。
三、每个判断都有数字。 防抖、调色、码率、验收——没有一个是"我觉得"。
四、改完必抽帧复查。 靠这个抓到过整行字幕消失(% 触发)和空片段(取素材越界)两个静默失败。
要改的三个地方
一、成片时长应该在第一轮就问清。 我在音乐生成后才发现时长对不上,多了一轮返工。
二、检测方法要有"元检查"意识。 音频那次,四轮检查全部通过时我就该警觉——"所有指标都正常但用户说有问题",本身就是最强的异常信号。
三、写文档前先确认复盘对象。 技术教程和协作复盘是两种产出物,我默认成了前者。
一个可以固化的清单
本项目的验收清单,可以直接复用到下一个视频项目:
① 输出时长 == 预期
② 逐片段查时长,无 N/A
③ 音频真实解码长度 == 视频长度(差 < 0.3s)
④ 全片 silencedetect 扫描
⑤ 结尾单看电平曲线,是"有意的淡出"还是"没了"
⑥ 逐镜头抽帧复查一遍画面
第 ③ 和第 ⑥ 条是最容易省、也最容易翻车的两条。
附录:本项目全部产出
| 文件 | 说明 |
|---|---|
东岸滨江骑行_成片.mp4 |
正片,2:47,78 小节对齐 112 BPM |
AI是怎么剪出这条成片的.mp4 |
教程,2:24,46 句解说 |
AI拆解_东岸滨江骑行_完整版.mp4 |
合成版,5:14(拆解 + 正片) |
教学插图/ |
过程分析图与示意图 |
cover/bili_1146x717/ |
B站 规格封面候选 6 张 |
教学_用CodeBuddyCLI剪视频.md |
本文 |
封面
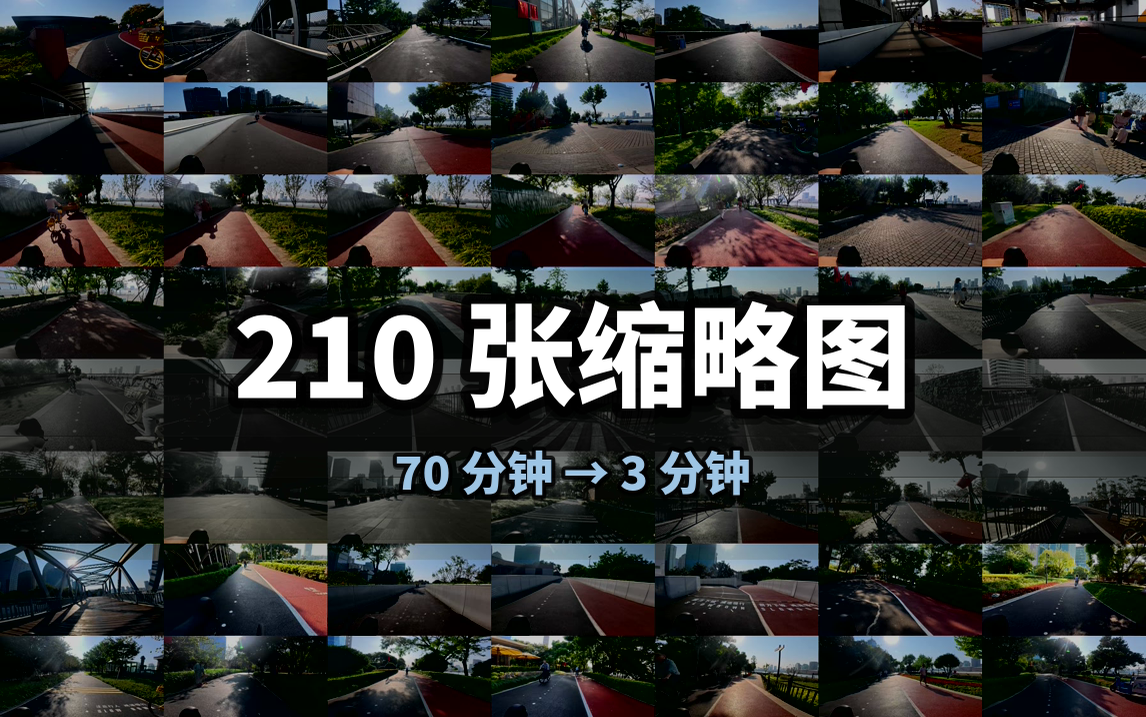
教程片封面。用大字报做钩子——背景是真实生成的接触印相图,它就是"抽帧"这件事本身。
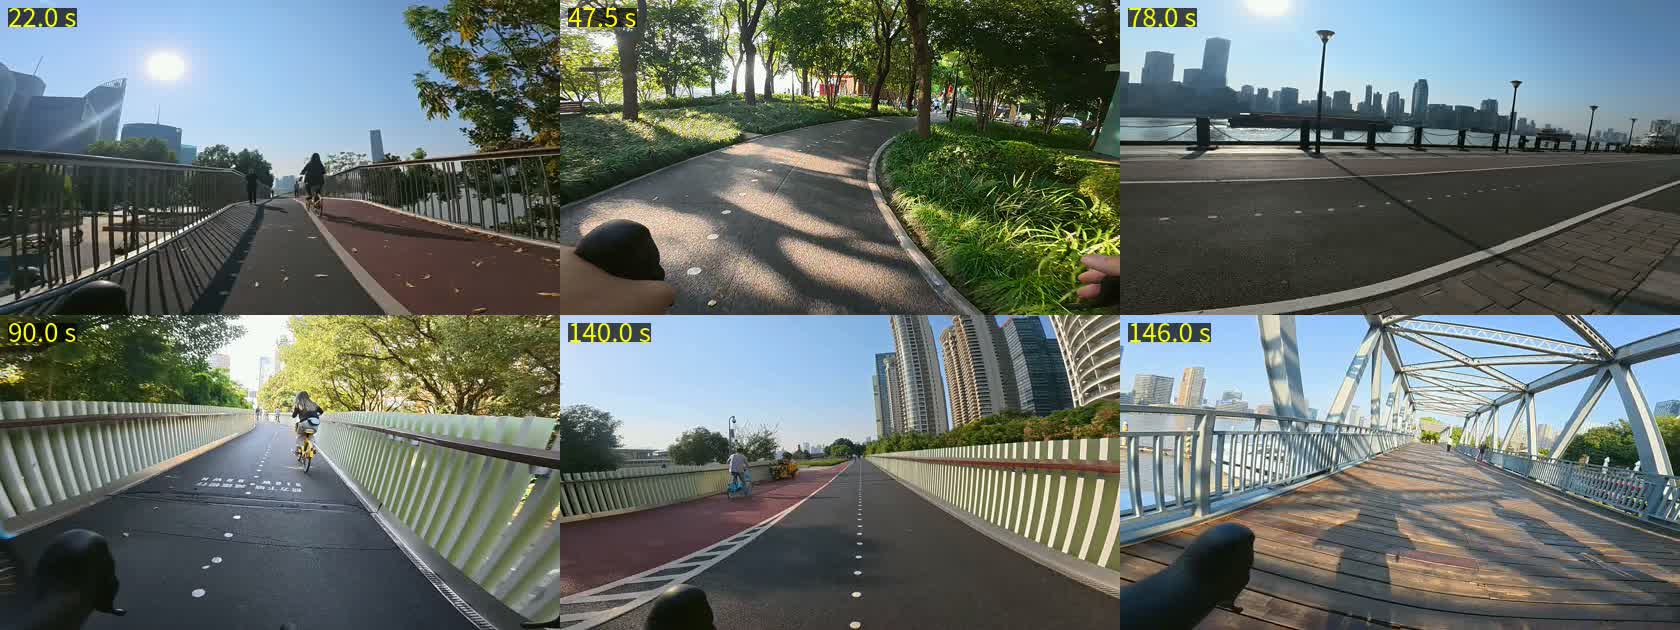
正片封面候选。选点全部避开字幕区间,避免封面带着正片字幕。
关键数字一览
| 指标 | 值 |
|---|---|
| 素材 | 70 分钟 / 11.18 GB / 1920×1080 HEVC |
| 成片 | 2 分 47 秒 / 78 小节 / 15.3 Mbps / -14.7 LUFS |
| 抽帧量 | 210 张(20秒间隔)+ 数百张(2秒/0.2秒精度) |
| 文字产出 | 914 字解说 + 9 条字幕 + 简介 + 文档 |
| 用户指令 | 25 条,平均长度约 12 字 |
| 结构化提问 | 2 轮 × 4 个问题 |
| 踩到的静默失败 | 7 类 |
| 我做错的判断 | 2 次(音频检测方法、复盘对象) |